

AIエージェントの導入や評価を検討する企業にとって、専門的な知見を持つ AIコンサルティング会社 の活用は重要な選択肢の一つです。AIエージェントは、質問への回答だけでなく、情報収集や分析、外部ツールの操作などを自律的に実行できるため、従来のAIシステムとは異なる評価基準が求められます。
特に、実際の業務でAIエージェントを活用する場合、最終的な回答の正確性だけでなく、タスクの達成度、ツールの利用方法、セキュリティ、権限管理、処理の安定性などを総合的に検証する必要があります。適切な評価基準やテスト方法を設定しなければ、誤判断や誤操作などが業務上のリスクにつながる可能性もあります。
本記事では、AIエージェントを評価する際の主な基準から、実践的なテスト手順、評価時の注意点まで詳しく解説します。さらに、コンサルティング会社にAIエージェントの評価・検証を依頼するメリットについても紹介します。
なぜAIエージェントの評価が不可欠なのか?
AIエージェントの導入を成功させるためには、従来のシステム開発や一般的なAI構築とは異なる「評価(Evaluation)」のアプローチが不可欠です。なぜAIエージェントにおいて評価がこれほど重要視されるのか、その主な理由を3つの観点から解説します。
チャットボット評価との違い:「回答の質」から「行動の正確性」へ
従来のChatGPTに代表されるチャットボットや生成AIは、主に「入力されたプロンプトに対して適切な回答テキストを生成すること」が目的でした。そのため、評価軸も自然言語処理の精度や情報の正確性といった「回答の質(Output Quality)」が中心でした。
一方で、AIエージェントはユーザーの指示に応じて必要な処理を判断し、外部APIやデータベース、各種ツールを利用しながら複雑なタスクを実行します。つまり評価対象が単なるテキスト生成の質から、「目標達成に向けた一連の実行プロセスやツール利用の正確性」へと根本的に変化しています。
AIの自律的な行動によるビジネスリスク
AIエージェントは自律的に判断してアクションを起こすため、制御や評価が不十分な場合、重大なビジネスリスクを発生させる可能性があります。
- 誤ったデータ変更・更新: データベースやCRM(顧客管理システム)の誤書き換え、間違ったデータの削除
- 不適切な外部送信: 誤った顧客へのメール自動送信、決済処理やシステム操作の失敗
- 権限の逸脱: アクセス権限のない機密情報や個人情報へのアクセス・出力
「回答が少し不自然」で済むチャットボットと異なり、AIエージェントの誤動作は業務の停止や信用失墜、実被害に直結するため、事前の厳密な評価と制限(ガードレール)が不可欠です。
本番運用前後における継続的な評価の必要性
AIエージェントの評価は、リリース前の開発段階(PoC)だけで終わるものではありません。
LLM(大規模言語モデル)は確率的に挙動が変化する非決定的な特性を持っています。また、連携する外部ツールのAPI仕様変更や、入力されるデータの多様化によって、導入当初は問題なく動いていたエージェントが急に誤作動を起こすリスクもあります。そのため、「導入前の事前評価」と「本番運用(Production)後の継続的なモニタリング・評価」の双方向のアプローチが必須となります。
>>>関連記事:
AIエージェントを評価する5つの基本基準
AIエージェントのパフォーマンスや安全性を正しく把握するには、単一の指標ではなく多角的な視点で評価することが不可欠です。実務において必ず押さえるべき「5つの基本基準」を解説します。
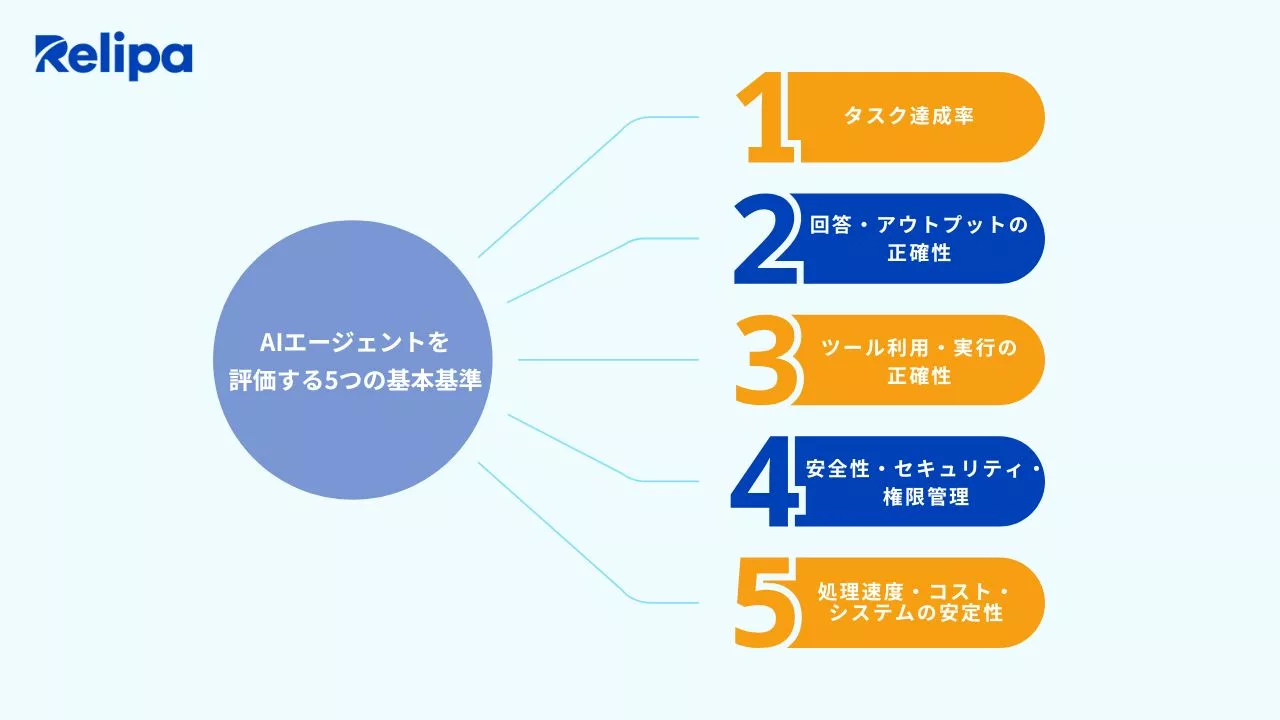
タスク達成率(Task Success Rate)
ユーザーから与えられた目標(Goal)を、最後まで正確に完了できた割合を示す最も重要な指標です。
- Primary Success Rate: 提示された指示に対して、最終成果物を意図通りに完遂できたか
- Sub-goal Completion Rate: 複雑なタスクを複数のステップ(サブタスク)に分解した際、各プロセスの達成度はどの程度か
最終結果だけでなく「途中のステップでどこまで到達できたか」を可視化することで、どこにボトルネックがあるかを特定しやすくなります。
回答・アウトプットの正確性(Accuracy & Hallucination)
タスクの過程や最終結果として出力される情報の精度を評価します。
- Factuality: 根拠となるデータに基づいた正確な事実を述べているか
- Hallucination Rate: AI特有の「嘘の情報」や不確実な推測を出力していないか
- Relevance: ユーザーの質問や指示に対して、過不足のない適切な情報量を提示できているか
特に専門知識を扱う業務では、ハルシネーション(嘘の情報生成)の発生率を低く抑えることが運用の前提となります。
ツール利用・実行の正確性(Tool Use)
外部APIやデータベースを操作する「Tool Call(Function Calling)」機能が正しく作動しているかを測定します。
- Tool Selection: 目的達成のために、複数あるツールの中から最適なものを選べているか
- Parameter Generation: ツールに引き渡す引数(検索条件やIDなど)を正確に生成できているか
- Execution Sequence: 依存関係のある複数のツールを、正しい順番で実行できているか
ツール選定や引数の指定ミスは、後続の処理全体に影響を及ぼすため、エージェント評価の要となるポイントです。
安全性・セキュリティ・権限管理(Guardrails & Permissions)
ビジネス環境でAIエージェントを稼働させる上で、リスク管理の観点から欠かせない基準です。
- Jailbreak Resistance: 悪意あるプロンプト(プロンプトインジェクション等)に耐性があるか
- Permission Control: 実行ユーザーのアクセス権限を超えたデータ閲覧・操作を行わないか
- Loop Prevention: 判断に迷った際、無意味なツール呼び出しを延々と繰り返す「無限ループ」を検知・回避できるか
機密情報を取り扱う企業の導入では、セキュリティガイドラインに準拠したガードレール設計が強固に機能しているかを厳しく検証する必要があります。
>>>関連記事:
処理速度・コスト・システムの安定性(Latency, Cost & Robustness)
実際の業務運用に耐えうる実用性(UXと運用コスト)を評価する基準です。
- Latency(応答時間): 指示を出してからタスクが完了するまでの時間
- Token Cost(コスト効率): LLMの呼び出しやAPI連携にかかる費用の最適化度合い
- Robustness(堅牢性): 外部ツールの通信エラーなどが発生した際、適切に再試行(フォールバック)できるか
この5つの基準を自社の業務に合わせて重み付けし、バランスよく検証することが成功への近道です。
ただし、これらの評価項目を自社内で独自に定義し、テスト環境まで構築するのは容易ではありません。「自社業務に最適な指標の設定が難しい」「どこから手をつけるべきか分からない」という場合は、高度な専門知識と実績を持つコンサルティング会社に相談し、評価枠組みの設計からサポートを受けるのが確実なアプローチです。
AIエージェントの実践的なテスト・評価手順
AIエージェントの評価基準を整理した後は、具体的なテストプロセスへ落とし込んでいきます。精度と再現性の高い評価を行うための実践的な5つのステップを解説します。
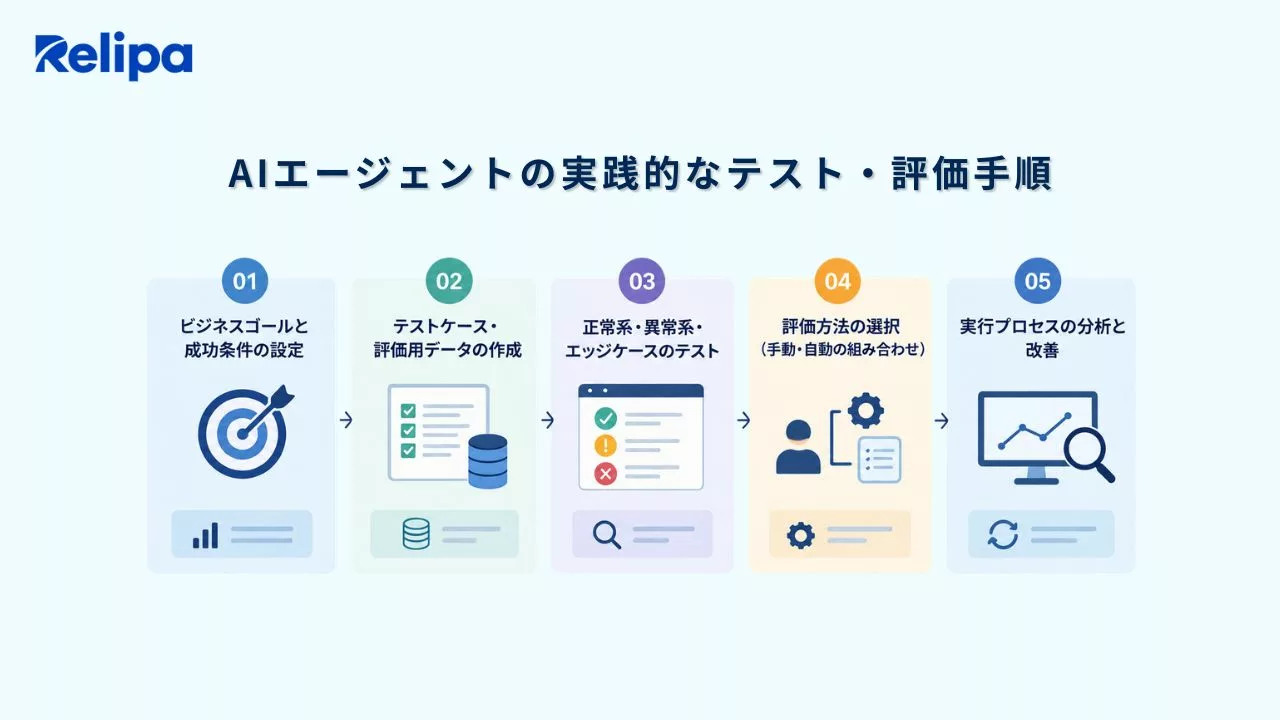
Step 1:ビジネスゴールと成功条件の設定
まずは「何を達成すれば成功とするか」を定量的なKPIとして定義します。
単に「問い合わせ対応を自動化する」といった定性的な目標ではなく、「一次回答の完遂率85%以上」「1件あたりの平均処理時間2分以内」「誤操作・誤発注率0%」のように、ビジネスインパクトに直結する数値を設定します。
Step 2:テストケース・評価用データの作成
評価のブレを無くし再現性を確保するために、あらかじめ正解データを定義した「ゴールデンセット(評価用データセット)」を作成します。
- 入力プロンプト: ユーザーからの指示バリエーション
- 想定される思考・行動プロセス: 使用すべきツールやその順番
- 期待される最終成果: 正しい出力結果や更新データ
実業務で発生し得る多様なパターンを網羅できるよう、十分な数のテストケースを用意します。正常系だけでなく、異常系やエッジケースも含めて評価できるデータセットを設計することが重要です。
Step 3:正常系・異常系・エッジケースのテスト
作成したテストケースを用いて、さまざまなシナリオでの挙動を検証します。
- 正常系(Happy Path): 典型的な指示に対して、想定通りのプロセスで正確にタスクを完遂できるか
- 異常系(Unhappy Path): 存在しないデータの検索要求や外部ツールのシステムエラー発生時に、適切にハンドリングできるか
- エッジケース(Edge Cases): 矛盾する指示や極端に長い文面、悪意のあるプロンプト(プロンプトインジェクション)を与えられた際に予期せぬ動作をしないか
Step 4:評価方法の選択(手動・自動評価の組み合わせ)
目的や評価リソースに応じて、最適なテスト手法を組み合わせて実行します。
- Human Evaluation(人間による目視評価): 定性的な出力のニュアンスや業務適合性を人が細かくチェック
- LLM-as-a-Judge(AIによる自動評価): GPT-4oやClaudeなどの高精度LLMを評価者として活用し、ログデータを大量かつ高速にスコアリング
- 専用評価ツールの活用: LangSmith、Ragas、TruLensなどの評価フレームワークを導入し、テストの実行と指標化を自動化
初期段階ではHuman Evaluationで定性リスクを洗い出し、規模が拡大した段階でLLM-as-a-Judgeや評価ツールによる自動化へ移行するのが効率的です。
Step 5:実行プロセス・ツール利用履歴の分析と改善
テスト実行後は、単にスコアを集計するだけでなく、AIエージェントの実行トレースやツール呼び出し履歴(Execution Log)を詳細に分析します。
タスクに失敗した場合、「プロンプトの記述不足か」「ツールの説明文(Description)が不適切か」「モデル自体の推論能力不足か」など原因を特定し、プロンプト調整やツールのリファクタリングを行って再テストを繰り返します。
このテスト・評価手順を網羅的かつ継続的に実行するには、専門的なツール選定や高度なテストシナリオ設計のノウハウが必要です。自社リソースだけで高度な評価環境を構築・運用するのが難しい場合は、知見豊富なコンサルティング会社にPoC段階から伴走を依頼することで、短期間で高品質な評価プロセスを確立できます。
AIエージェント評価で陥りがちな落とし穴・注意点
AIエージェントの評価環境やテスト体制を構築する際、多くの企業が直面する代表的な失敗パターンがあります。導入後の失敗を防ぐために、あらかじめ押さえておくべき3つの注意点を解説します。
最終結果だけでなく実行プロセスも確認する
「最終的に正しい回答が得られたか」という結果(Output)のみを評価していると、重大なリスクや課題を見落とす危険があります。
例えば、最終的な成果物は合っていても、途中で「無関係なツールを数十回呼び出していた」「個人情報が含まれるデータベースを不要に検索していた」といったケースが存在します。これはレスポンスの遅延やトークンコストの増大を引き起こすだけでなく、将来的なセキュリティ事故の原因にもなります。必ず実行プロセスやツールの実行履歴を追跡・監査することが重要です。
単発の成功率だけでなく再現性・堅牢性を確認する
LLM(大規模言語モデル)は確率的に出力を生成する特性(非決定性)を持つため、同じ指示を与えても実行ごとに挙動が異なる場合があります。
たまたま1回のテストで成功したからといって「タスク完了」と判断せず、同じテストケースを複数回実行した際の再現性(Repeatability)を確認してください。また、ユーザーの言い回しやプロンプトのフォーマットが少し変わっても安定して動作するかという「堅牢性(Robustness)」の検証も不可欠です。
ビジネスリスクに応じて評価基準に優先順位をつける
すべての評価項目において100点を目指すのは、開発コストおよび時間的観点から現実的ではありません。自社のビジネスリスクに合わせて評価基準の優先順位(ウェイト)を決定することが重要です。
- 社内データ参照・要約エージェント: 「回答の正確性」「処理速度」を重視
- 発注・決済・DB更新を伴うエージェント: 「安全性・権限管理」「ツール利用の正確性」を最優先とし、厳格なガードレールを設定
自社業務における「許容できる失敗」と「絶対にあってはならない失敗」を明確に整理し、それに応じた評価合格ライン(閾値)を設定しましょう。
このように、AIエージェントの評価には従来のシステム開発とは異なる多角的なアプローチが必要です。実行プロセスの検証やリスク評価の設計は専門性が高く、社内リソースのみでの対応に限界を感じるケースも少なくありません。
適切な評価設計に不安がある場合は、AI導入実績が豊富なコンサルティング会社のノウハウを活用し、自社に最適な評価フレームワークを構築するのが最も効果的です。
AIエージェントの評価・検証をAIコンサルティング会社に依頼するメリット
AIエージェントの評価体制を構築するには、プロンプトエンジニアリングや外部ツールのAPI連携だけでなく、セキュリティ設計やセキュリティガードレールの構築、LLM-as-a-Judgeといった最新の自動評価手法への深い理解が求められます。
専門的なノウハウを持つAIコンサルティング会社を活用することで、自社リソースのみで対応する際のリスクや時間を大幅に削減し、以下のような具体的なメリットを得ることができます。
業務に適した評価基準・フレームワークを設計できる
汎用的な評価指標をそのまま適用するだけでは、自社固有の複雑な業務プロセスに対応できないケースが多々あります。経験豊富なAIコンサルティング会社は、貴社の事業ドメインや業務フローを深く理解した上で、実務に即した再現性の高い評価基準(メトリクス)やテスト用データセット(ゴールデンセット)をゼロからカスタマイズ設計します。
PoCから本番移行までセキュリティ・システム連携を検証できる
AIエージェントを本番環境(Production)へ導入する際、最も大きな障壁となるのが「セキュリティ」と「既存システムとの統合」です。専門のコンサルティング会社に依頼することで、プロンプトインジェクション対策やアクセス権限管理、基幹システム・CRMとのAPI連携における安全性を技術的・客観的な視点から包括的にテスト・検証できます。
導入後の継続的なモニタリング・改善を支援できる
AIエージェントは一度構築して終わりではなく、LLMモデルのアップデートや業務データの変化に応じて定期的な性能チェックと改善が欠かせません。AIコンサルティング会社の支援を受けることで、本番環境での実行ログの監視体制や、ログデータを活用した継続的な評価・改善サイクル(PDCA)をスムーズに自社内に定着させることが可能となります。
AIエージェント評価チェックリスト
AIエージェントの評価体制を自社で構築する際、あるいはAIコンサルティング会社と評価プロジェクトを進める際にそのまま活用できる「評価チェックリスト」をまとめました。
要件定義から本番運用後のモニタリングまで、各フェーズで以下のポイントを網羅できているか確認してください。
| 評価項目 | 確認ポイント |
| 1. タスク達成率 | ユーザーの意図に沿って、タスクを最後まで正確に完了できているか |
| 2. サブタスク達成率 | 複数ステップにわたるタスクを、それぞれ正しく実行できているか |
| 3. ハルシネーション制御 | 事実と異なる情報や、根拠のないデータを出力していないか |
| 4. ツール選定精度 | 必要なAPIやデータベース、外部ツールを適切に選択できているか |
| 5. パラメータ生成精度 | ツール呼び出し時の引数(SQLクエリや検索パラメータなど)に誤りがないか |
| 6. アクセス・権限管理 | 実行ユーザーの権限を超えたデータの参照・変更・削除を行っていないか |
| 7. セキュリティ・ガードレール | プロンプトインジェクションなどの不適切な指示や、異常なツール呼び出し・ループを検知・制御できるか |
| 8. 処理速度 | 実業務で許容される時間内に、応答や処理を完了できているか |
| 9. コスト効率 | 1タスクあたりのLLM利用コストが想定予算内に収まっているか |
| 10. 例外処理・復旧対応 | ツール通信エラーなどが発生した際に、適切なエラー処理や再試行、フォールバックができるか |
このチェックリストを活用することで、評価の漏れを防ぎ、AIエージェントの品質と安全性を定量的に把握できます。
項目ごとの合格基準(閾値)の設定や、複雑な自動テスト基盤の構築については、AIコンサルティング会社のノウハウを組み合わせることでより効果的に進めることが可能です。
まとめ
AIエージェントの評価は、従来のチャットボットのように「回答テキストの精度」を見るだけでは不十分であり、「自律的な判断と行動の正確性」「ツールの適切な利用」「安全性やコスト」を多角的に検証することが成功の鍵となります。
また、確率的に挙動が変化するAIエージェントの品質を担保するには、明確な評価指標の設定からテストケースの作成、本番運用後のモニタリングまで、一貫した評価体系の構築が欠かせません。
AIエージェントの評価・開発なら、実績豊富なレリパ(Relipa)にご相談ください
AIエージェントの導入や評価環境の構築には、高度な技術的知見と実践的なノウハウが必要です。「自社業務に合わせた評価基準の作り方が分からない」「セキュリティや誤動作のリスクを最小限に抑えて本番運用したい」とお悩みの方は、ぜひレリパ(Relipa)にお任せください。
レリパ(Relipa)は、日本市場向けに数多くのAIシステムおよびエージェント開発、高負荷なシステム構築を手掛けてきた豊富な実績を持っています。
- 業務に特化した評価フレームワークの設計
- PoC(概念実証)から本番稼働に向けたセキュリティ・システム検証
- 導入後の継続的なモニタリング・改善(PDCA)の伴走サポート
貴社の課題や業務フローに応じた最適なAIエージェントの評価・検証および開発体制をご提案いたします。まずはお気軽にレリパ(Relipa)にご相談(無料)ください。